Design and Implementation of Low-Power, Energy-Efficient Neural Network Training Hardware
Accelerators Based on Brain Floating-Point Computing and Sparsity Aware
摘要:
在本研究中,我們提出一個具有高效能、高靈活性的訓練處理器,我們把它命名為EESA。
擬議的訓練處理器具有低功耗、高吞吐量和高能效等特點。EESA利用神經元激活的稀疏性來減少記憶體訪問的次數以及記憶體儲存的空間,
以實現高效的訓練加速器。所提出的處理器使用了一種新穎的可重新配置的計算架構,在正向傳播(FP)以及反向傳播(BP)過程中保持高性能。
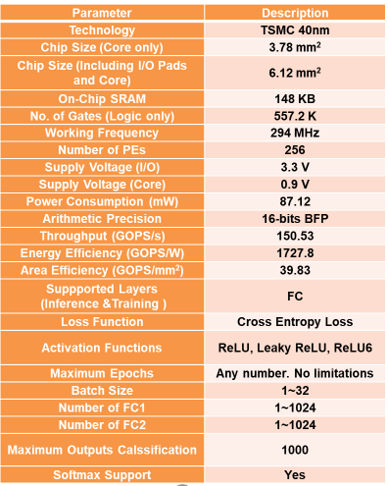
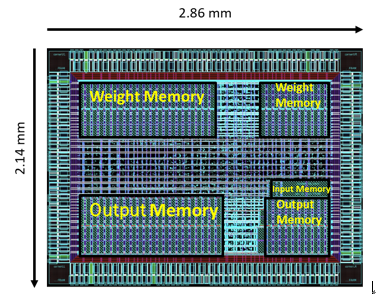
該處理器採用台積電40 nm工藝技術實現,能運行的操作頻率為294 MHz,整個晶片的功耗為87.12 mW,使用的核心電壓為0.9 V。在整個晶片中,
我們使用16位元的腦浮點運算精度格式來完成所有資料的數值運算,最終該處理器實現了1.72 TOPS/W的高能效表現。
研究貢獻:
q
擬議的處理器使用
16-bits brain floating point
這種新穎的運算精度格式。
q通過使用一個新穎的可重新配置的處理元件(PE)架構,來完成全連接層的訓練及推理階段。
q 擬議的處理器利用神經元的稀疏性及結合了實驗室提出的優化記憶體訪問方法,來減少正向傳播及反向傳播運算所需要的記憶體空間及記憶體訪問的次數,來提高能源效率。
q 所提出的硬體設計在台積電40nm工藝技術中實現,在294MHz和0.9V的核心電壓下,實現了87.12mW的功耗及1.72TOPS/W的能源效率。
Proposed Overall Architecture:

Implementation Results:
Made
by 林定邦